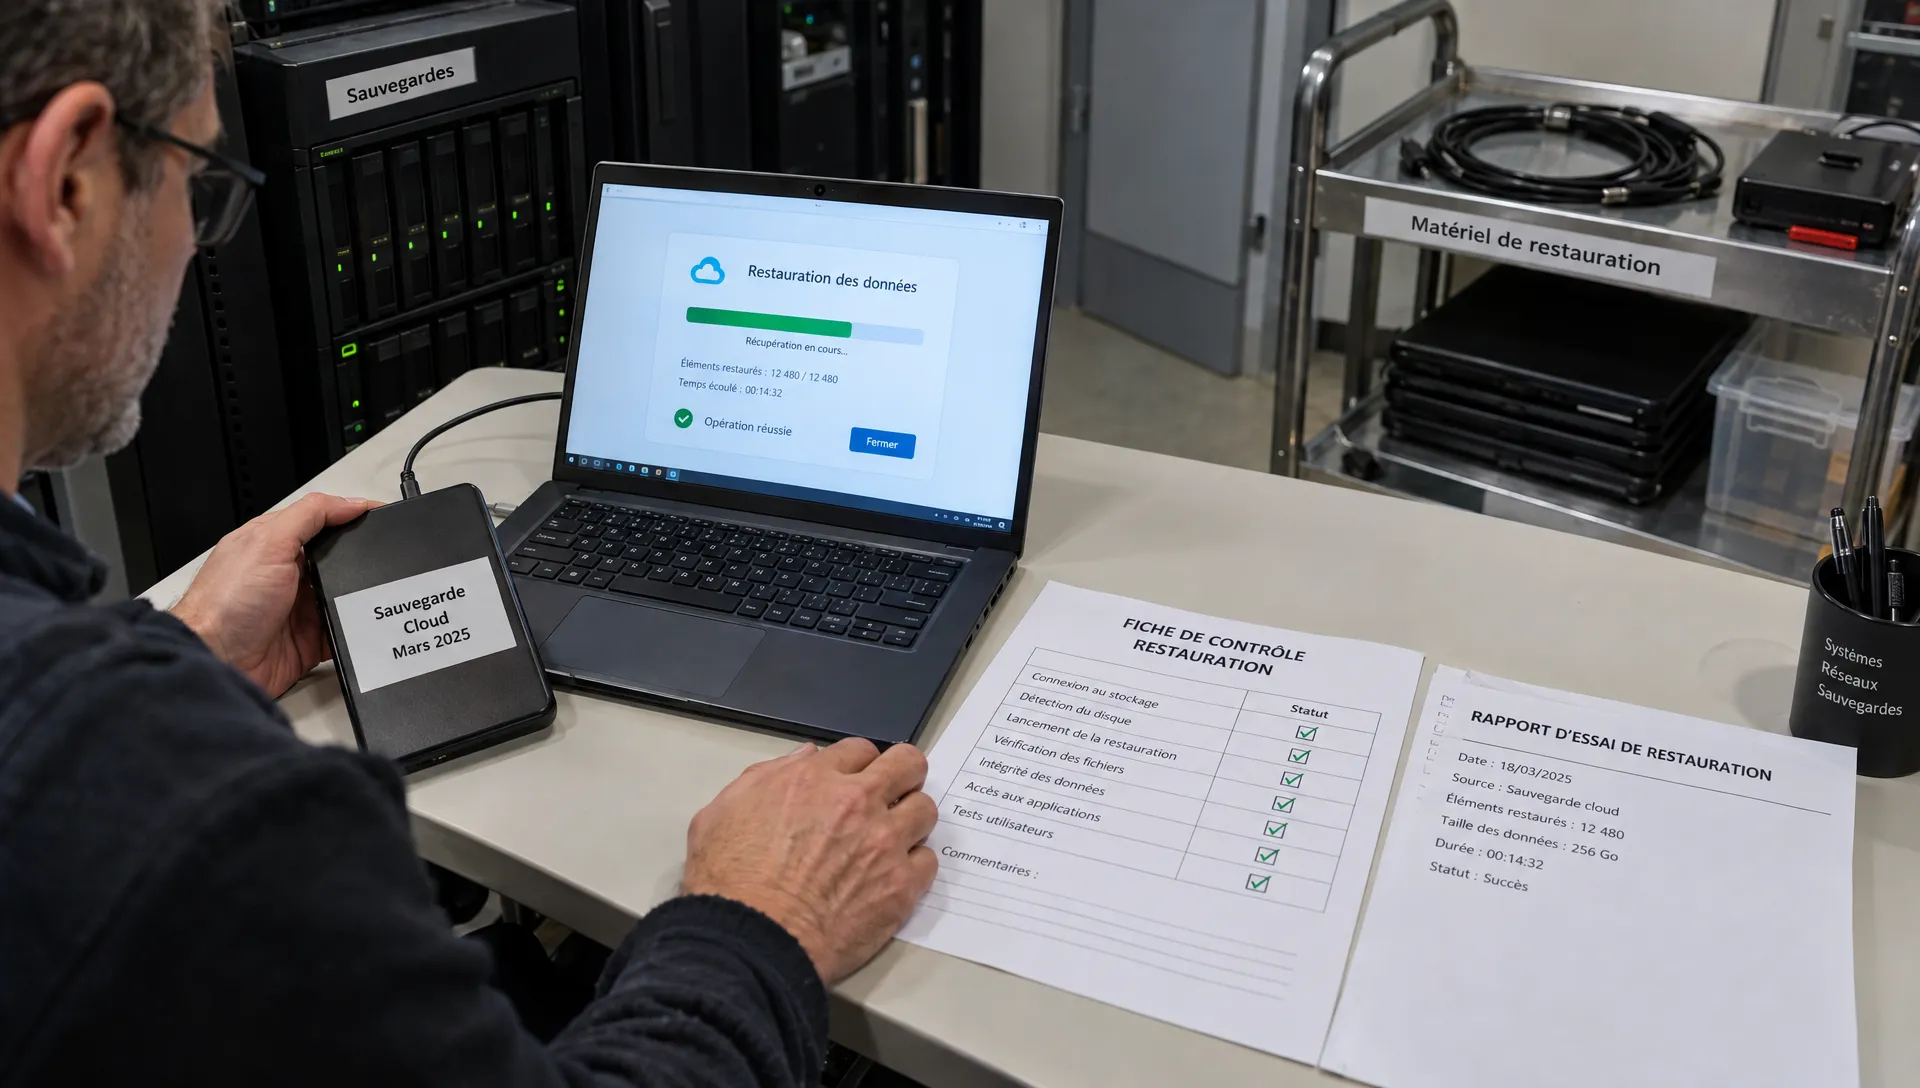
Évaluer la dépendance à un service de cloud consiste à mesurer les conséquences d’une indisponibilité, d’une perte d’accès ou d’un changement de fournisseur. Le bon indicateur n’est pas seulement la facilité d’exporter les données : c’est la capacité à maintenir ou rétablir l’activité dans des délais et à un coût acceptables. Pour décider, il faut croiser criticité métier, dépendances techniques, engagements contractuels et résultats de tests.
Mesurer la dépendance cloud pour protéger l’activité
Distinguer usage du cloud et dépendance excessive
La dépendance cloud désigne les contraintes qui limitent votre capacité à exploiter, récupérer ou remplacer une ressource hébergée. Elle devient problématique lorsque ces contraintes dépassent ce que votre organisation peut supporter.
Utiliser une technologie propriétaire n’est donc pas nécessairement un mauvais choix. Elle peut apporter une réelle valeur, à condition que ses conséquences soient connues, chiffrées et acceptées. À l’inverse, une infrastructure reposant sur des formats standards peut rester très dépendante d’un prestataire si personne d’autre ne possède les accès ou la documentation.
L’analyse concerne les logiciels en ligne (SaaS), les plateformes applicatives (PaaS) et les infrastructures hébergées (IaaS). Dans un SaaS, l’attention porte notamment sur les données et les processus métier. Pour une infrastructure, elle porte aussi sur les configurations réseau, les identités, les outils d’administration et les compétences nécessaires à l’exploitation.
1. Fixer les limites acceptables avec les métiers
Avant d’examiner les technologies, demandez aux responsables opérationnels ce que l’organisation peut réellement tolérer. La dépendance à un service de cloud ne se mesure pas de la même manière pour un outil secondaire et pour une application qui permet de facturer ou de délivrer un service public.
Deux objectifs structurent cette discussion :
- RTO, objectif de délai de reprise : durée cible pour rétablir un service après une interruption.
- RPO, objectif de perte de données : ancienneté maximale des données que l’organisation accepte de perdre, exprimée en durée.
Ajoutez le coût d’une journée d’arrêt, les périodes sensibles et les possibilités de fonctionnement dégradé. Une équipe peut-elle enregistrer temporairement les commandes autrement ? Les agents disposent-ils des informations nécessaires pour poursuivre l’accueil ?
Ces objectifs doivent être validés par les métiers, puis confrontés aux capacités techniques. Un RTO souhaité de quatre heures ne prouve pas qu’une reprise en quatre heures est réalisable. L’écart entre l’objectif et le résultat d’un exercice constitue précisément un indicateur de risque.
2. Cartographier les dépendances, pas seulement les applications
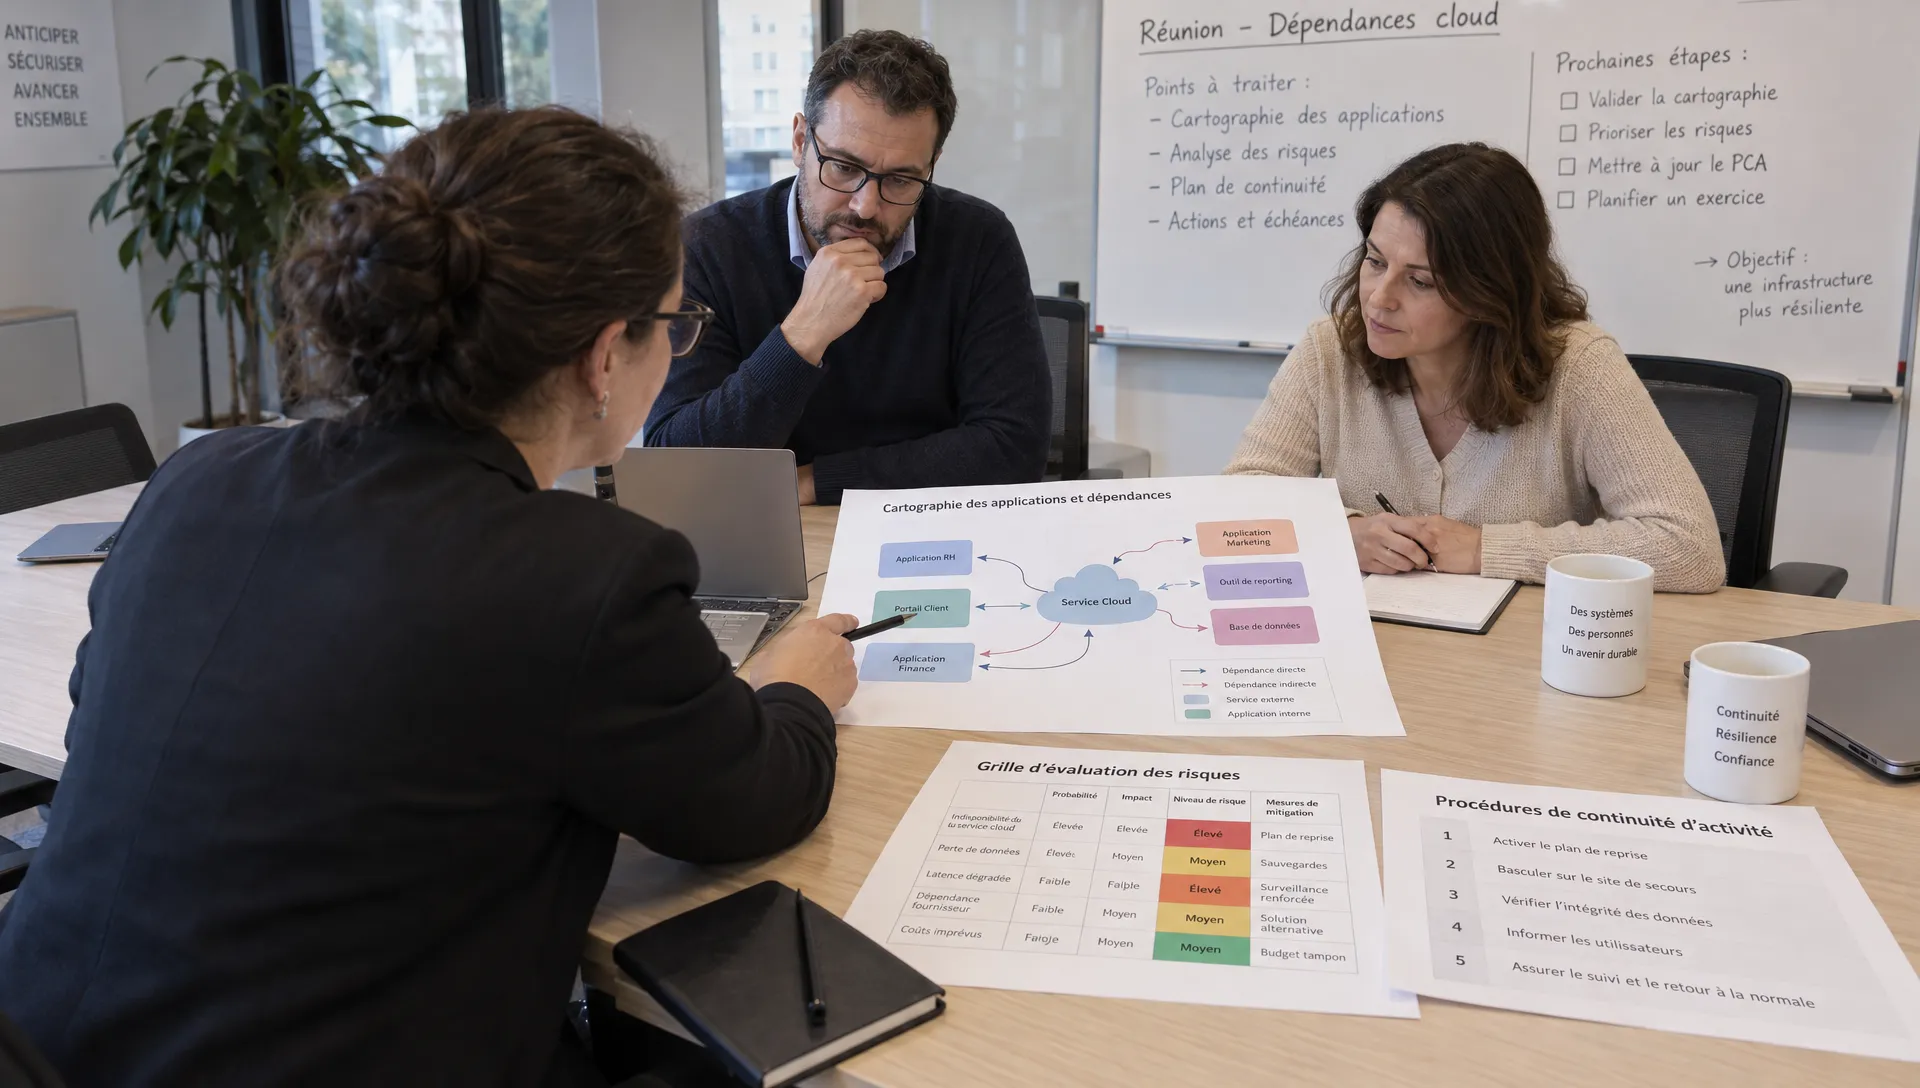
Pour chaque application importante, représentez la chaîne nécessaire à son fonctionnement : connexion internet, résolution des noms de domaine (DNS), authentification, application, base de données, interfaces et sauvegardes.
Identifiez ensuite qui contrôle chaque maillon. Une messagerie, un outil de gestion et une sauvegarde peuvent sembler indépendants tout en utilisant le même annuaire d’identités ou le même compte d’administration. Cette concentration crée un point de défaillance commun.
La cartographie d’un service de cloud doit donc répondre à une question opérationnelle : quels autres services deviennent inutilisables si ce composant ou cet accès disparaît ?
Examinez aussi les dépendances humaines. Si un unique intervenant connaît la configuration ou détient les droits nécessaires, le risque dépasse le seul fournisseur cloud. Vérifiez que l’organisation dispose de comptes administrateurs maîtrisés, d’une documentation accessible et d’un dispositif de secours approprié.
Pour un environnement multisite, distinguez les dépendances locales des dépendances partagées. Une panne de liaison dans une agence n’a pas les mêmes conséquences qu’une défaillance de l’authentification utilisée par tous les établissements.
3. Évaluer six dimensions avec des preuves
Une grille utile confronte chaque risque à un élément vérifiable. Les déclarations commerciales ne suffisent pas pour qualifier la dépendance à un service de cloud : il faut des contrats, des configurations documentées et des résultats d’essais.
| Dimension | Question à trancher | Preuve à rechercher |
|---|---|---|
| Portabilité technique | Peut-on réutiliser les données et les configurations ailleurs ? | Export représentatif et essai d’import dans une cible identifiée |
| Maîtrise des accès | Peut-on administrer et récupérer les ressources sans l’intervenant habituel ? | Inventaire des droits et procédure d’accès de secours testée |
| Autonomie d’exploitation | Une autre équipe peut-elle comprendre et reprendre le fonctionnement ? | Documentation, procédures et transfert de compétences vérifié |
| Continuité et récupération | Une panne ou une compromission bloque-t-elle aussi la reprise ? | Test de restauration et analyse des dépendances communes |
| Dépendance économique | Le coût du maintien ou du changement reste-t-il acceptable ? | Simulation budgétaire complète et hypothèses explicites |
| Contraintes contractuelles et données | Les conditions de récupération et les responsabilités sont-elles définies ? | Contrat, modalités d’export, assistance et délais documentés |
Attribuer une note sans masquer les risques critiques
Vous pouvez utiliser une échelle interne de 0 à 3. Ce barème est une méthode de travail, pas une norme ni une certification.
Une note 0 correspond à une alternative effectivement testée et compatible avec les objectifs métier. Une note 1 signale des adaptations nécessaires, mais déjà validées et supportables. Une note 2 indique une solution identifiée qui dépasse les limites de délai, de coût ou de compétences retenues. Une note 3 correspond à l’absence d’alternative exécutable identifiée.
Inscrivez « non évalué » lorsqu’aucune preuve n’est disponible. L’absence d’information ne doit pas devenir artificiellement une bonne note.
Évitez de piloter uniquement avec une moyenne : cinq résultats satisfaisants ne compensent pas une impossibilité de restaurer l’application centrale. Le diagnostic d’un service de cloud doit conserver visibles les risques bloquants, leur impact métier et les preuves manquantes.
4. Tester la dépendance à un service de cloud
Un engagement contractuel indique ce qui est prévu. Un exercice montre ce que votre organisation sait réellement faire. Les tests doivent être autorisés, préparés et conduits sur un périmètre maîtrisé, sans provoquer une interruption non contrôlée de la production.
Scénario A : perte d’accès au fournisseur ou à l’authentification
Vérifiez comment joindre le support si la messagerie habituelle est indisponible. Confirmez que les procédures d’urgence ne sont pas conservées uniquement dans l’environnement devenu inaccessible.
Testez également les accès de secours prévus pour l’administration. Ils doivent être protégés, limités et contrôlés. L’objectif n’est pas de contourner la sécurité, mais de vérifier que la procédure autorisée fonctionne.
Le délai de réponse du support n’équivaut pas au délai de rétablissement de votre application. Pour analyser cette différence, confrontez vos besoins aux SLA cloud adaptés aux applications critiques, en distinguant disponibilité, prise en charge et reprise effective.
Scénario B : récupération de données après incident
Demandez la restauration d’un jeu de données représentatif, puis faites contrôler son utilité par un utilisateur métier. Un fichier récupéré n’est pas nécessairement un service rétabli : droits, pièces jointes, historiques et relations entre données peuvent manquer.
La synchronisation réplique les modifications et peut aussi propager une suppression. Une sauvegarde vise à récupérer un état antérieur selon ses modalités de conservation. L’archivage répond à une autre finalité, celle de conserver des informations dans la durée. Ces mécanismes ne sont pas interchangeables.
Pour un service de cloud critique, mesurez le délai complet jusqu’à la reprise métier, pas seulement la durée de téléchargement.
Exemple purement illustratif : rapatrier 600 Go sur un site avec un débit de 50 Mbit/s entièrement disponible pour ce transfert demande environ 27 heures théoriques. Les contrôles et le rétablissement applicatif s’ajoutent ensuite. Cette méthode de récupération ne peut donc pas satisfaire un objectif de reprise de huit heures.
Scénario C : reprise par une autre équipe
Faites examiner les procédures par une personne compétente qui ne les a pas rédigées. Peut-elle identifier les ressources, comprendre les flux et retrouver les paramètres indispensables sans solliciter constamment l’exploitant habituel ?
Pour un SaaS, vérifiez également qu’un export contient des informations exploitables dans une autre solution. Des fichiers CSV peuvent restituer les données principales sans reproduire les circuits de validation, les automatisations ou les rapports.
Consignez le résultat de chaque essai : périmètre, date, durée observée, éléments manquants et conséquences métier. Le compte rendu doit permettre de distinguer une capacité démontrée d’une simple possibilité technique.
5. Chiffrer le maintien, l’incident et le changement
Le prix mensuel ne mesure pas la dépendance économique. Pour évaluer un service de cloud, comparez trois situations : continuer dans les conditions actuelles, subir une interruption significative et devoir changer de solution.
Le scénario de maintien doit intégrer les volumes, les licences, la supervision, la sécurité et les évolutions prévisibles. Le scénario d’incident ajoute les interventions, le travail de récupération et les pertes d’exploitation estimées par les métiers.
Le scénario de changement comprend notamment l’extraction des données, les transferts, la conversion, la reconfiguration des interfaces, les tests et la formation. Une période de double exploitation peut aussi être nécessaire. Les frais applicables doivent être vérifiés dans les conditions contractuelles, sans présumer qu’un export gratuit rend toute la transition gratuite.
Présentez une fourchette fondée sur des hypothèses explicites plutôt qu’un montant artificiellement précis. Distinguez les dépenses ponctuelles des charges récurrentes, puis comparez ce coût au risque financier que l’organisation accepte.
Cette analyse peut justifier le maintien chez le fournisseur actuel. L’objectif n’est pas de changer à tout prix, mais d’éviter qu’un changement nécessaire devienne économiquement impossible.
6. Vérifier les contrats et la maîtrise des données
Examinez les conditions de suspension, de résiliation et de récupération des données. Les formats disponibles, les délais d’accès après la fin du contrat et le périmètre de l’assistance doivent être suffisamment clairs pour construire un scénario réaliste.
Pour les données personnelles, vérifiez notamment le contrat de sous-traitance, les sous-traitants ultérieurs et les éventuels transferts hors de l’Espace économique européen. Le texte officiel du RGPD, notamment ses articles 28, 32 et 44 à 49, fournit le cadre de référence à examiner avec votre DPO ou votre conseil selon la situation.
La localisation d’un service de cloud constitue un critère, mais elle ne démontre pas à elle seule la maîtrise des données. Il faut aussi connaître les acteurs impliqués, les accès d’administration et les modalités de récupération.
Enfin, vérifiez la répartition des responsabilités entre hébergeur, éditeur, intégrateur et infogérant. Un incident devient plus difficile à traiter lorsque chaque intervenant attend l’action d’un autre sans procédure d’escalade définie.
7. Prioriser les corrections selon le risque métier
Croisez la criticité de l’activité avec les dépendances observées. Une application essentielle sans procédure de récupération testée appelle une action prioritaire. Un outil secondaire difficile à remplacer peut relever d’un traitement programmé, si son interruption reste supportable.
Pour chaque écart, attribuez un responsable, une échéance et un critère de réussite observable. « Améliorer la sauvegarde » reste trop vague. « Réaliser une restauration représentative et mesurer le délai jusqu’à validation métier » permet de contrôler l’avancement.
Toutes les corrections ne nécessitent pas une nouvelle architecture. Documenter les configurations, clarifier les responsabilités ou tester un accès de secours peut réduire une dépendance à moindre coût. Le multicloud n’est pas automatiquement la réponse : deux fournisseurs peuvent rester dépendants du même annuaire, du même réseau ou de la même équipe.
Lorsque la portabilité constitue le risque principal, les résultats du diagnostic servent à préparer la réversibilité du cloud. L’évaluation d’un service de cloud identifie ainsi les écarts à traiter, sans se substituer au projet de sortie lui-même.
Intégrer les contraintes des Antilles-Guyane
En Martinique, en Guadeloupe et en Guyane, l’analyse doit intégrer la connectivité réellement disponible sur chaque site. Mesurez les temps d’accès depuis les établissements concernés et vérifiez la capacité de la liaison de secours avec les usages prioritaires.
Deux abonnements ne prouvent pas une indépendance physique : demandez ce qui peut être confirmé concernant les parcours réseau et les points communs. Un hébergement proche peut réduire certaines contraintes, mais il faut toujours examiner les domaines de défaillance partagés.
La dépendance à un service de cloud comprend aussi la capacité d’intervention : qui agit sur le site, qui pilote l’incident et quelle assistance est disponible lorsque l’équipe habituelle ne l’est pas ?
Pour une organisation multisite, formalisez enfin un mode dégradé par établissement. Il doit préciser les opérations encore possibles sans accès central, les informations disponibles localement et les modalités de réconciliation au retour du service.
Questions fréquentes
Quelle différence entre dépendance cloud et verrouillage fournisseur ? La dépendance couvre l’ensemble des contraintes techniques, économiques, humaines et opérationnelles. Le verrouillage fournisseur désigne plus précisément les obstacles qui rendent le changement difficile ou coûteux. On peut dépendre fortement d’un service pourtant exportable.
Un export des données suffit-il à prouver l’autonomie ? Non. Il faut vérifier son exhaustivité et sa réutilisation. Les permissions, les interfaces et les processus métier peuvent nécessiter une reconstruction. Un test d’import apporte une preuve plus solide qu’une liste de formats disponibles.
Une sauvegarde indépendante supprime-t-elle la dépendance ? Elle peut réduire le risque de perte de données, mais ne remplace ni l’application ni ses compétences d’exploitation. La restauration doit rester possible avec les accès, les clés éventuelles et les outils nécessaires, y compris lorsque l’environnement principal est indisponible.
Faut-il toujours privilégier un cloud local ? Le choix dépend des usages, des besoins d’intervention et des contraintes de connectivité ou de données. Un service de cloud local doit être évalué avec les mêmes exigences de preuve qu’une autre offre : récupération, sécurité, responsabilités et continuité.
Quand refaire cette évaluation ? Après une évolution majeure : nouvelle application critique, acquisition, changement de fournisseur, modification de l’authentification ou incident significatif. Une revue périodique adaptée à la criticité permet aussi de vérifier que les procédures et les hypothèses restent valables.
Faire évaluer votre dépendance cloud avec AITEC
AITEC accompagne les entreprises et collectivités des Antilles-Guyane en audit, conseil, cloud, cybersécurité et exploitation des infrastructures. Cette approche permet de relier les choix techniques aux besoins de continuité et aux capacités réelles de l’organisation.
Pour étudier votre stratégie cloud avec AITEC, préparez la liste de vos applications critiques, vos contrats et vos derniers résultats de restauration. Ces éléments constituent un point de départ concret pour identifier les dépendances prioritaires et définir les vérifications à mener.