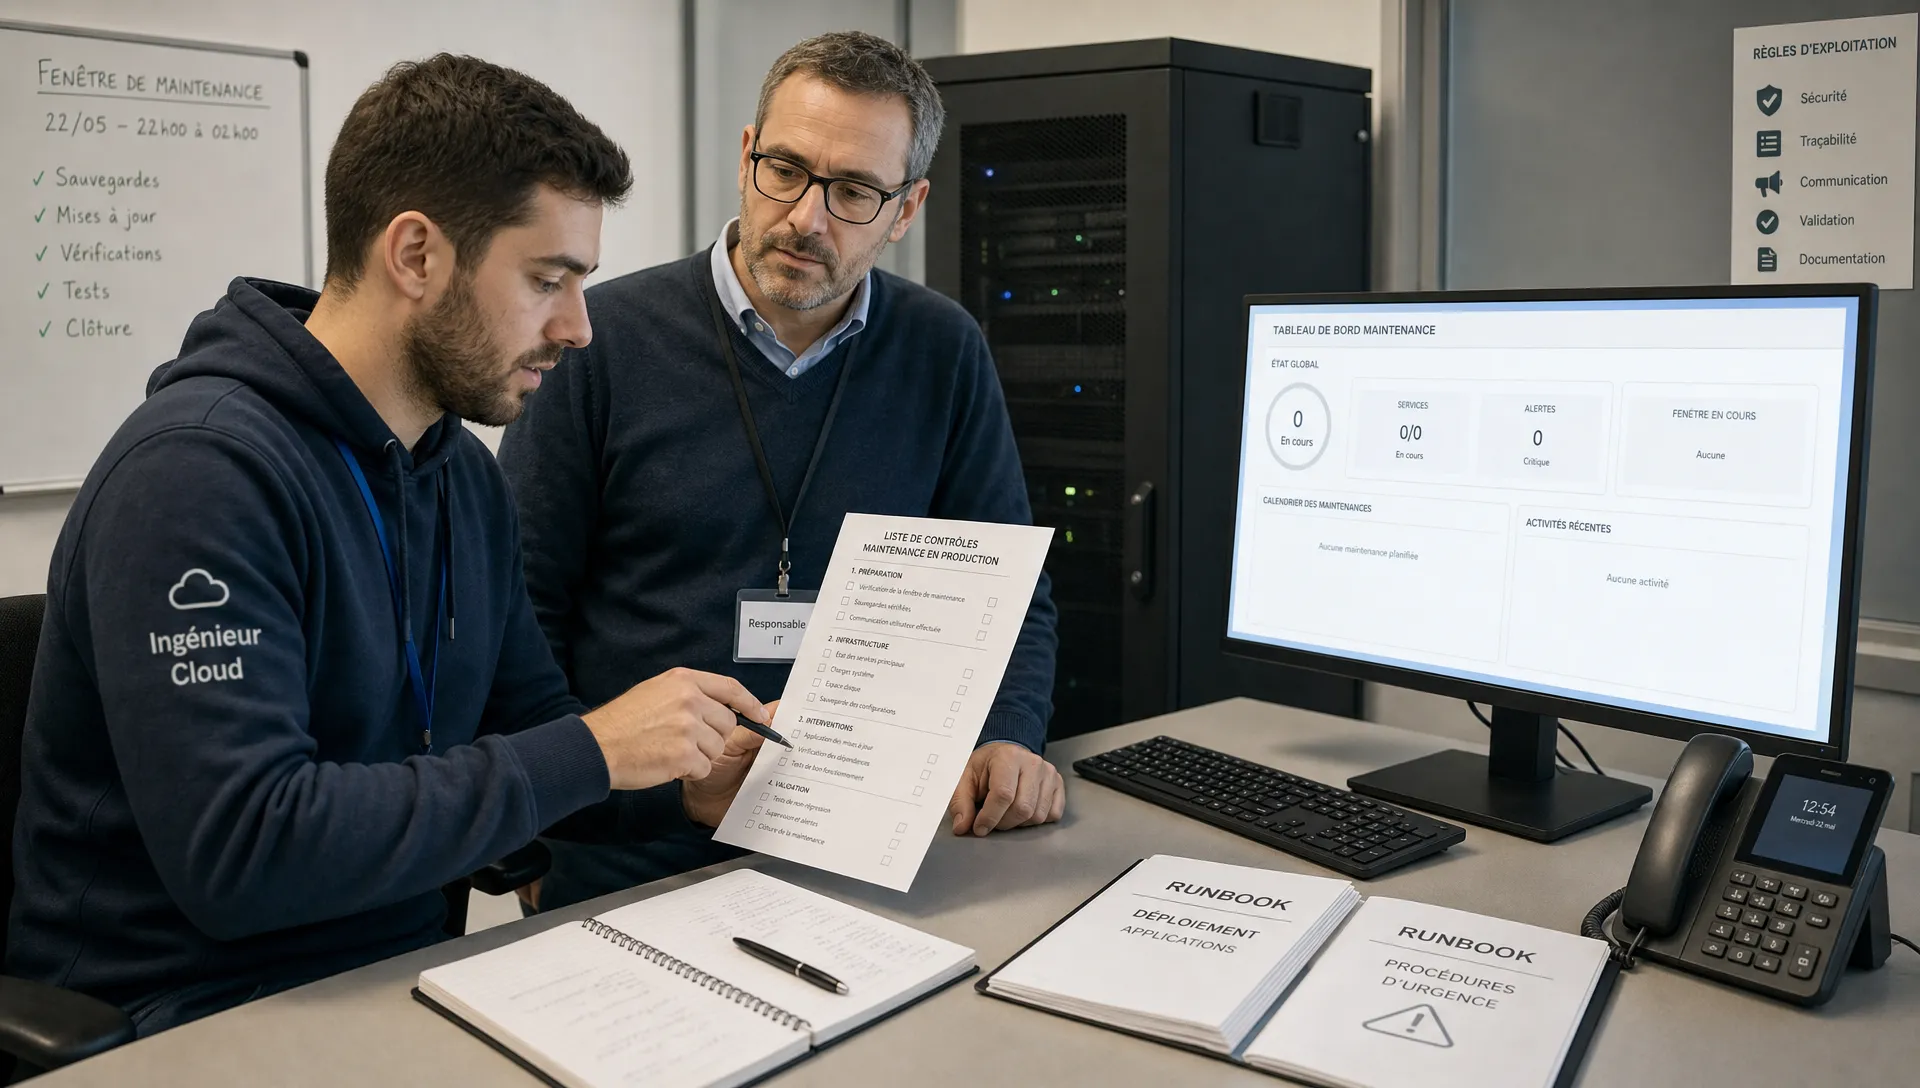
La maintenance cloud de vos applications critiques doit être organisée comme un processus d’exploitation continu, pas comme une intervention ponctuelle lorsqu’un incident survient. Pour un dirigeant de PME, un DSI ou une collectivité en Martinique, Guadeloupe ou Guyane, l’enjeu est simple : maintenir les services métier disponibles, sécurisés, sauvegardés et évolutifs malgré les mises à jour, les changements applicatifs, les incidents réseau et les risques cyber.
Une application critique peut être un ERP, un logiciel de caisse, une plateforme de gestion de production, un portail usager, un outil RH, une messagerie ou une application métier utilisée sur plusieurs sites. Sa maintenance ne concerne pas seulement l’infrastructure cloud. Elle couvre aussi les accès, les sauvegardes, la supervision, les correctifs, les dépendances réseau, la documentation et les procédures de reprise.
Pourquoi structurer la maintenance cloud des applications critiques
Sans organisation claire, le cloud peut donner une fausse impression de simplicité. Les serveurs sont externalisés, les ressources sont flexibles et les sauvegardes peuvent être automatisées, mais les responsabilités restent bien réelles. Qui valide un correctif ? Qui intervient lorsqu’une base de données ralentit ? Qui vérifie qu’une sauvegarde est restaurable ? Qui prévient les métiers avant une opération sensible ?
La maintenance cloud permet de répondre à ces questions avant l’incident. Elle transforme une exploitation réactive en pilotage maîtrisé, avec des responsabilités, des priorités, des seuils d’alerte et des procédures documentées. Pour une application critique, cette discipline réduit les interruptions non planifiées, améliore la sécurité et facilite les arbitrages budgétaires.
Distinguer MCO, MCS et amélioration continue
Le maintien en condition opérationnelle, ou MCO, vise à conserver le service disponible et performant. Il inclut la supervision, la gestion des incidents, le suivi des capacités, les redémarrages contrôlés, la gestion des certificats et la vérification des sauvegardes.
Le maintien en condition de sécurité, ou MCS, traite les vulnérabilités, les correctifs, les droits d’accès, les journaux, les configurations exposées et les alertes de sécurité. Dans ce contexte, la maintenance cloud doit être reliée à la cybersécurité, car une application hébergée peut être disponible tout en restant mal protégée.
L’amélioration continue complète ces deux volets. Elle consiste à analyser les incidents récurrents, supprimer les tâches manuelles inutiles, ajuster les ressources et faire évoluer l’architecture lorsque les usages changent.
Commencer par classer les applications selon leur criticité
Toutes les applications n’ont pas le même niveau de risque. Une panne de portail interne n’a pas le même impact qu’une indisponibilité de facturation, de gestion logistique ou de prise en charge d’usagers. Avant de définir un plan de maintenance cloud, il faut donc classer les applications selon leur impact métier.
Cette classification doit être réalisée avec les équipes métier, pas seulement avec l’équipe informatique. Les directions administratives et financières, responsables de sites, DSI, RSSI et responsables métiers n’ont pas toujours la même perception du risque. L’objectif est de traduire les contraintes opérationnelles en exigences exploitables.
| Niveau de criticité | Exemple d’impact | Exigence de maintenance |
|---|---|---|
| Critique | Arrêt de facturation, production, accueil usager ou accès métier principal | Supervision renforcée, astreinte selon contrat, procédures de reprise testées |
| Important | Dégradation de productivité ou retard opérationnel significatif | Suivi régulier, correctifs planifiés, sauvegardes contrôlées |
| Standard | Gêne limitée, contournement possible | Maintenance programmée, support aux heures définies |
| Faible | Usage ponctuel ou non prioritaire | Suivi périodique, documentation minimale suffisante |
Pour les environnements déjà en production, un audit cloud avant validation ou évolution permet de vérifier les ressources, les accès, les sauvegardes, la sécurité et les dépendances avant de réorganiser l’exploitation.
Cartographier les dépendances invisibles
Une application cloud critique dépend rarement d’un seul serveur. Elle peut s’appuyer sur une base de données, un annuaire d’identités, un stockage objet, des API externes, un VPN, un pare-feu, un certificat TLS, un service DNS et une liaison réseau entre plusieurs sites.
La cartographie doit inclure les flux entrants et sortants, les comptes de service, les accès administrateurs, les dépendances avec les postes utilisateurs et les horaires de forte activité. Sans cette vision, la maintenance cloud risque de corriger un composant sans mesurer son effet sur l’ensemble du service.
Définir les rôles avant de définir les outils
Beaucoup d’organisations commencent par choisir une console, un outil de supervision ou une solution de sauvegarde. Ces outils sont utiles, mais ils ne remplacent pas une organisation claire. La première question reste : qui fait quoi, dans quel délai et avec quel niveau d’autorité ?
Un modèle simple consiste à formaliser les responsabilités entre la direction, les métiers, l’équipe informatique interne, le prestataire cloud, l’infogérant et les éditeurs applicatifs. Ce modèle évite les zones grises, notamment lors d’un incident où chaque minute perdue augmente l’impact métier.
| Domaine | Responsabilité à clarifier | Risque si non défini |
|---|---|---|
| Supervision | Qui reçoit et qualifie les alertes | Alertes ignorées ou traitées trop tard |
| Correctifs | Qui valide, teste et déploie | Patchs bloqués ou déploiements risqués |
| Sauvegardes | Qui contrôle les jobs et les restaurations | Données sauvegardées mais non récupérables |
| Sécurité | Qui analyse les journaux et les vulnérabilités | Exposition prolongée à une faille connue |
| Communication | Qui informe les utilisateurs et la direction | Confusion pendant l’incident |
Cette répartition doit être documentée dans un plan d’exploitation. Pour la maintenance cloud d’applications critiques, ce document doit rester court, utilisable en situation réelle et mis à jour après chaque changement significatif.
Les processus clés d’une maintenance cloud fiable
Une organisation mature ne repose pas sur une seule procédure. Elle combine supervision, gestion des incidents, patch management, sauvegardes, sécurité, tests et reporting. Ces processus doivent être adaptés à la criticité de chaque application.
Superviser ce qui a un impact métier
Surveiller uniquement l’état d’une machine virtuelle ne suffit pas. Une application peut être allumée mais inutilisable, lente ou inaccessible depuis un site distant. La supervision doit donc couvrir les métriques techniques et l’expérience utilisateur.
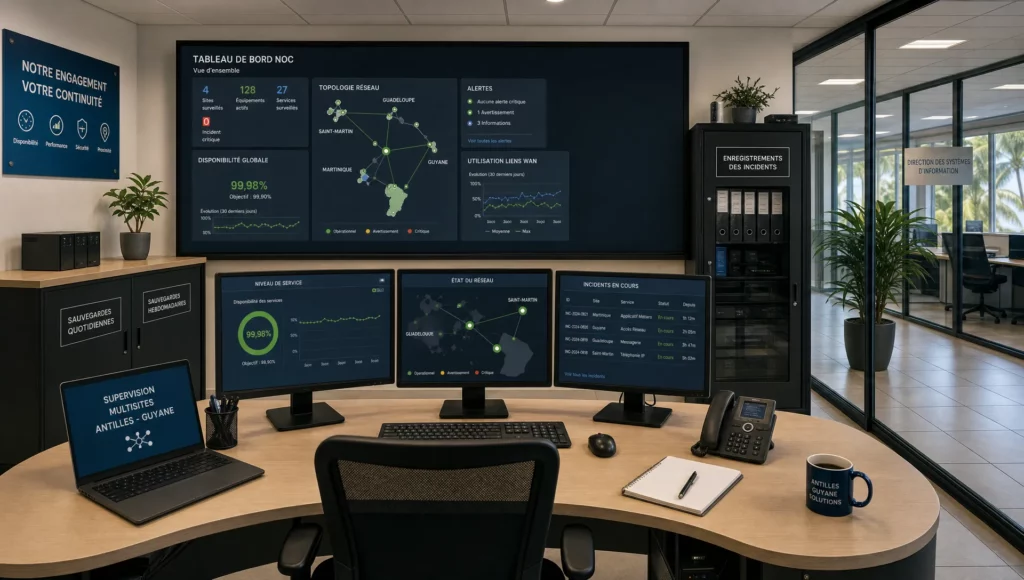
Les indicateurs utiles incluent la disponibilité applicative, les temps de réponse, l’usage CPU et mémoire, les volumes de stockage, les erreurs applicatives, les expirations de certificats, les échecs de connexion, les sauvegardes en erreur et les anomalies réseau.
La maintenance cloud devient plus efficace lorsque les alertes sont qualifiées par criticité. Une saturation disque sur une application critique n’a pas le même traitement qu’une alerte informative sur un environnement de test. Les seuils doivent être ajustés pour éviter deux problèmes opposés : le silence dangereux et l’avalanche d’alertes ignorées.
Planifier les correctifs sans casser la production
Les mises à jour de systèmes, bases de données, composants applicatifs et agents de sécurité sont indispensables, mais elles peuvent provoquer des incompatibilités. Pour les applications critiques, les correctifs doivent suivre une séquence maîtrisée : qualification, test, validation métier si nécessaire, planification, sauvegarde préalable, déploiement, contrôle et possibilité de retour arrière.
L’ANSSI rappelle dans son guide d’hygiène informatique l’importance de maintenir les systèmes à jour et de maîtriser les droits d’administration. Cette recommandation s’applique pleinement aux environnements cloud, où les ressources évoluent vite et où une configuration oubliée peut rester exposée.
Une bonne maintenance cloud prévoit aussi des fenêtres adaptées aux usages locaux. Une PME avec plusieurs points de vente en Guadeloupe, un service public à Cayenne ou une entreprise multisite entre Fort-de-France et Le Lamentin n’ont pas les mêmes contraintes horaires.
Tester les sauvegardes et les restaurations
Une sauvegarde réussie n’est pas forcément une reprise réussie. Le point déterminant est la capacité à restaurer les données et les services dans un délai compatible avec l’activité. Deux notions doivent être définies pour chaque application : le RTO, délai maximal acceptable de reprise, et le RPO, perte maximale de données acceptable.
Les tests de restauration doivent être planifiés. Ils peuvent porter sur un fichier, une base de données, une machine virtuelle ou une application complète. Leur fréquence dépend de la criticité, du volume de données et des contraintes métiers.
Pour les organisations soumises au RGPD, la protection des données personnelles doit aussi être prise en compte dans les accès, les sauvegardes et les journaux. La CNIL fournit des recommandations sur la sécurité des données qui peuvent servir de base aux contrôles internes.
Organiser la gestion des incidents et des changements
La maintenance cloud ne supprime pas les incidents. Elle réduit leur fréquence, leur impact et leur durée en définissant un mode opératoire avant la crise. Ce mode opératoire doit préciser les niveaux de priorité, les personnes à prévenir, les informations à collecter et les critères de retour à la normale.
Pour une application critique, un incident n’est pas seulement un ticket technique. C’est un événement métier qui peut affecter la production, la trésorerie, l’accueil client, la continuité du service public ou la conformité. Les équipes doivent donc savoir quand escalader vers la direction et quand déclencher un plan de continuité ou de reprise.
La gestion des changements suit la même logique. Chaque évolution d’architecture, modification de règles réseau, montée de version ou migration de base doit être évaluée avant déploiement. Les changements les plus sensibles doivent disposer d’un plan de retour arrière.
Encadrer les niveaux de service
Les SLA, ou accords de niveau de service, doivent être lisibles et mesurables. Ils peuvent couvrir la disponibilité, les délais de prise en charge, les délais de rétablissement, les plages de support, les sauvegardes, la supervision et la communication en cas d’incident.
Un SLA ne doit pas être confondu avec une promesse vague. Il doit préciser ce qui est inclus, ce qui ne l’est pas, les exclusions, les responsabilités du client et celles du prestataire. Pour approfondir ce point, vous pouvez consulter les SLA cloud à exiger pour vos applications critiques.
Dans la pratique, la maintenance cloud s’appuie sur ces engagements pour prioriser les interventions et arbitrer les ressources. Plus une application est critique, plus les niveaux de service doivent être précis.
Adapter l’exploitation au contexte Antilles-Guyane
En Martinique, Guadeloupe et Guyane, l’exploitation cloud doit intégrer des contraintes spécifiques : distance avec certains centres de support, connectivité intersites, dépendance à des liaisons opérateurs, dispersion géographique et besoin d’intervention locale. Pour une organisation basée à Baie-Mahault, Pointe-à-Pitre, Fort-de-France ou Cayenne, ces réalités influencent les choix d’architecture et de support.
La maintenance cloud doit prévoir les cas où l’application fonctionne mais où un site distant ne peut plus y accéder correctement. Cela suppose de superviser les liens réseau, les accès VPN, les équipements de sécurité et les temps de réponse depuis les principaux sites utilisateurs.
L’autre enjeu est la continuité d’activité. Les périodes de forte activité, les contraintes logistiques et les événements locaux doivent être pris en compte dans le calendrier de maintenance. Une fenêtre de mise à jour mal placée peut provoquer plus de perturbations qu’un incident technique mineur.
Prévoir une assistance après la mise en production
Le passage en production n’est pas la fin du projet cloud. C’est le début de l’exploitation. Les premières semaines permettent souvent de détecter des seuils mal calibrés, des usages imprévus, des lenteurs applicatives ou des besoins d’assistance utilisateurs.
Une assistance structurée doit couvrir la supervision, le support, la gestion des incidents, les sauvegardes, la sécurité et l’amélioration continue. Ces éléments sont détaillés dans l’article consacré à l’assistance cloud après la mise en production.
Quels indicateurs suivre dans le temps ?
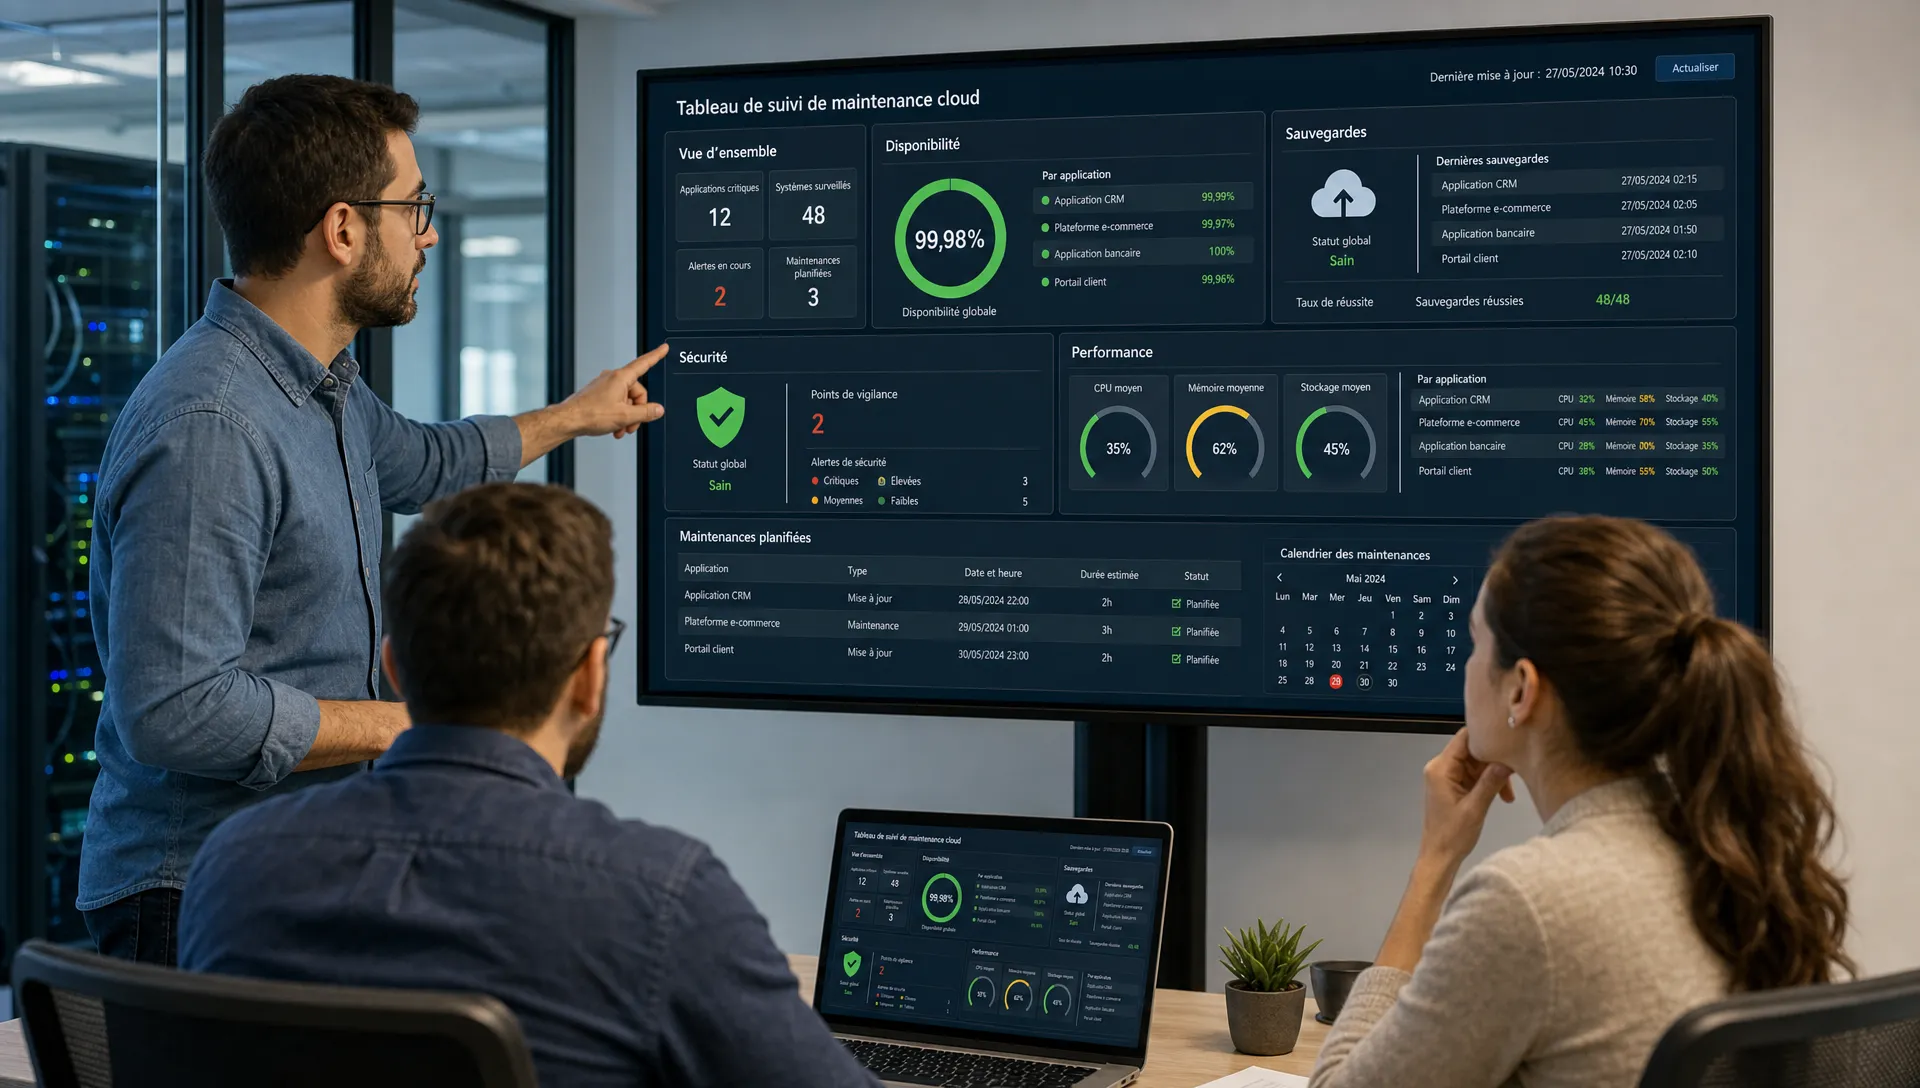
Un tableau de bord utile ne doit pas accumuler des métriques techniques sans décision associée. Il doit permettre au DSI, au responsable infrastructure ou à la direction générale de comprendre si le niveau de risque diminue, augmente ou reste stable.
La maintenance cloud doit produire des indicateurs réguliers, mais aussi des actions correctives. Un rapport qui signale trois mois de suite le même incident sans plan d’amélioration n’apporte pas de valeur opérationnelle.
| Indicateur | Ce qu’il mesure | Décision possible |
|---|---|---|
| Disponibilité applicative | Capacité des utilisateurs à accéder au service | Ajuster l’architecture ou les SLA |
| Incidents récurrents | Problèmes qui se répètent | Corriger la cause racine |
| Délai de résolution | Temps entre alerte et retour à la normale | Renforcer l’escalade ou le support |
| Échecs de sauvegarde | Fiabilité de la protection des données | Corriger les jobs ou revoir la stratégie |
| Correctifs en retard | Exposition à des vulnérabilités connues | Prioriser le patch management |
| Utilisation des ressources | Capacité CPU, mémoire, stockage et réseau | Optimiser les coûts ou dimensionner |
Ces indicateurs doivent être revus avec les métiers lorsque les impacts dépassent le périmètre IT. Une application lente peut sembler acceptable techniquement, mais bloquer la facturation ou rallonger le traitement d’un dossier usager.
Construire un plan d’action pragmatique en 30 jours
Réorganiser l’exploitation ne nécessite pas de tout reconstruire. Une démarche courte permet souvent de reprendre le contrôle, surtout lorsque les applications sont déjà hébergées dans le cloud mais que la maintenance reste informelle.
- Semaine 1 : inventorier les applications critiques, leurs propriétaires métier, leurs dépendances et les accès administrateurs.
- Semaine 2 : vérifier les sauvegardes, les restaurations, les journaux, les correctifs en retard et les seuils de supervision.
- Semaine 3 : formaliser les rôles, les procédures d’incident, les fenêtres de maintenance et les règles d’escalade.
- Semaine 4 : produire un tableau de bord simple, corriger les risques prioritaires et planifier les tests de reprise.
Ce plan ne remplace pas un audit complet, mais il donne une base concrète pour structurer la maintenance cloud et réduire les risques les plus visibles. Il permet aussi de préparer un échange plus précis avec un prestataire d’infogérance ou un partenaire cloud.
FAQ sur la maintenance des applications critiques dans le cloud
Quelle est la différence entre maintenance cloud et infogérance cloud ? La maintenance couvre les actions nécessaires pour conserver les applications disponibles, sécurisées et sauvegardées. L’infogérance cloud désigne généralement un service plus large, avec supervision, support, exploitation, reporting, conseil et amélioration continue selon un périmètre défini.
À quelle fréquence faut-il tester les sauvegardes ? La fréquence dépend de la criticité de l’application et des objectifs RTO/RPO. Pour une application critique, il est recommandé de planifier des tests réguliers et documentés, car une sauvegarde non testée ne prouve pas que la reprise sera possible dans les délais attendus.
Qui doit valider les fenêtres de maintenance ? Les fenêtres doivent être validées par l’informatique et les métiers concernés. Une opération techniquement simple peut avoir un impact fort si elle tombe pendant une clôture comptable, une période de forte fréquentation ou une campagne de traitement administratif.
Faut-il maintenir différemment une application cloud multisite ? Oui. Une application utilisée par plusieurs sites doit intégrer la supervision des accès réseau, des liens VPN, des performances depuis chaque site et des procédures de contournement. Le cloud peut être disponible alors qu’un site local rencontre une difficulté d’accès.
Un prestataire peut-il garantir l’absence d’incident ? Non. Aucun prestataire sérieux ne peut garantir l’absence totale d’incident ou de cyberattaque. En revanche, une organisation de maintenance structurée permet de réduire les risques, détecter plus vite les anomalies, limiter l’impact et améliorer la reprise.
Faire évaluer votre organisation de maintenance cloud
Si vos applications critiques sont déjà hébergées dans le cloud mais que les procédures, les sauvegardes, les SLA ou la supervision restent flous, un audit ciblé permet d’identifier les priorités sans interrompre l’activité.
AITEC accompagne les entreprises et collectivités de Martinique, Guadeloupe et Guyane sur l’audit, l’architecture, la migration, l’exploitation, la supervision, la cybersécurité, le support et l’amélioration continue des environnements IT. L’objectif n’est pas seulement de maintenir des serveurs, mais de sécuriser la continuité de vos services métier.
Pour avancer de manière structurée, vous pouvez échanger avec AITEC afin d’évaluer votre organisation actuelle, vos applications critiques et les actions prioritaires à mettre en place.