Dans une prestation « infogérance hébergement », l’hébergeur intervient sur l’infrastructure qu’il fournit et l’infogérant sur les systèmes qu’il exploite, selon leurs périmètres contractuels. Mais lorsqu’une application devient inaccessible, l’entreprise ne devrait pas avoir à déterminer seule lequel appeler. Un pilote d’incident doit être désigné pour qualifier la panne, mobiliser les intervenants et suivre le rétablissement du service. Ce rôle peut revenir à l’infogérant, à une équipe informatique interne ou à un prestataire intégré. Il doit être prévu avant l’incident, avec des engagements de support compatibles entre les différents contrats.
Gestion des incidents : rôles, coordination et engagements
Hébergement et infogérance : deux responsabilités différentes
L’hébergement consiste à mettre à disposition un environnement technique : espace en datacenter, ressources de calcul, stockage ou infrastructure cloud. Le niveau de responsabilité varie fortement. En colocation, les serveurs peuvent appartenir au client. Dans une offre de machines virtuelles, l’hébergeur fournit généralement une infrastructure dont l’administration du système d’exploitation n’est pas nécessairement incluse.
L’infogérance désigne la gestion externalisée de tout ou partie du système d’information. Elle peut couvrir la supervision, l’administration des serveurs, les correctifs, les sauvegardes et le support. Son périmètre dépend lui aussi du contrat, et non de l’appellation commerciale.
Une machine virtuelle peut donc être disponible alors que l’application qu’elle héberge ne fonctionne plus. À l’inverse, un système correctement administré peut devenir inaccessible à cause d’une panne de stockage chez l’hébergeur.
Un contrat « infogérance hébergement » doit préciser ces frontières, notamment pour les équipements réseau, les systèmes d’exploitation et les applications. Pour cadrer plus largement les tâches externalisées, la distinction entre ce qu’il faut déléguer en infogérance cloud et ce qu’il faut conserver en interne constitue un point de départ utile.
Qui intervient selon l’origine de l’incident ?
La répartition suivante est indicative. Elle doit être adaptée à l’architecture réelle et aux prestations souscrites. Le symptôme constaté par l’utilisateur ne suffit pas à identifier le responsable technique.
| Incident constaté | Intervenant technique habituel | Point à vérifier au contrat |
|---|---|---|
| Défaut d’alimentation ou de refroidissement du datacenter | Hébergeur ou exploitant du datacenter | Périmètre des infrastructures physiques et procédure de continuité |
| Panne du stockage ou de la plateforme de virtualisation fournie | Hébergeur | Responsabilité sur la couche d’infrastructure concernée |
| Service arrêté dans une machine virtuelle | Infogérant ou équipe interne | Administration du système et des services inclus |
| Erreur du logiciel métier | Éditeur, intégrateur ou mainteneur applicatif | Support applicatif et modalités de mobilisation |
| Connexion indisponible depuis un seul site | Opérateur, gestionnaire réseau ou infogérant | Responsabilité sur les liens et les équipements d’accès |
| Restauration nécessaire après une perte de données | Responsable de la sauvegarde, avec les autres intervenants | Exécution de la restauration et validation des données |
La matrice « infogérance hébergement » doit distinguer qui exécute l’action technique de qui coordonne l’incident. Un infogérant peut piloter les échanges avec l’hébergeur sans pouvoir réparer lui-même une panne physique.
La responsabilité contractuelle d’une interruption constitue encore une autre question. Elle s’analyse à partir des engagements souscrits et des faits établis, pas uniquement du composant sur lequel la panne apparaît.
Désigner un pilote pour éviter les renvois de tickets
Le pilote d’incident est l’interlocuteur chargé de suivre la résolution de bout en bout. Il rassemble les informations, sollicite les équipes compétentes, suit les actions et communique avec l’entreprise. Il ne remplace pas tous les spécialistes, mais évite que chacun attende une réponse de l’autre.
Lorsque l’entreprise conserve deux prestataires, un guichet unique reste possible. Il faut toutefois donner au pilote les moyens d’agir : autorisation d’ouvrir des tickets, références des contrats, accès nécessaires au diagnostic et contacts d’escalade. Un prestataire ne peut pas engager efficacement le support d’un fournisseur auquel il n’a aucun accès.
Un ticket de coordination peut centraliser l’impact métier, la chronologie et les décisions. Les tickets propres à l’hébergeur ou à l’éditeur y sont référencés pour conserver une vue d’ensemble sans imposer un outil commun à toutes les parties.
Le pilote du dispositif « infogérance hébergement » doit aussi connaître son remplaçant et les modalités de mobilisation hors des horaires habituels. Une boîte mail partagée ne constitue pas, à elle seule, une procédure d’urgence.
Enfin, l’entreprise garde un rôle : désigner la personne habilitée à arbitrer un arrêt temporaire, autoriser une restauration potentiellement destructive ou valider la reprise du service métier.
Quels engagements de support faut-il aligner ?
Un engagement de disponibilité de l’hébergement ne garantit pas le fonctionnement de l’application. De même, un délai de réponse du support ne correspond pas nécessairement à un délai de rétablissement.
Les SLA, ou engagements de niveau de service, doivent distinguer la prise en charge, l’escalade, la fréquence des communications et les objectifs de restauration. Leur mesure doit préciser le point de départ du délai, les horaires couverts et les éventuelles exclusions.
Vérifiez également la cohérence entre les contrats. Un support d’infogérance mobilisable la nuit peut rester bloqué si le support de l’éditeur indispensable à la résolution n’est accessible que le lendemain. Le contrat doit rendre cette dépendance visible.
Deux objectifs complètent ce cadrage : le RTO correspond au délai cible de reprise après une interruption ; le RPO exprime la perte de données maximale admissible, mesurée dans le temps. Ils se définissent selon les besoins métier, puis se confrontent aux capacités de sauvegarde et de restauration.
Ces objectifs ne deviennent pas automatiquement des garanties contractuelles. Ils doivent être traduits en moyens techniques, procédures et tests pour vérifier que le dispositif peut effectivement les atteindre.
Incidents « infogérance hébergement » : cinq étapes à formaliser
1. Qualifier le symptôme et l’impact
Le premier signalement doit préciser le service touché, l’heure de début, les sites concernés et les opérations bloquées. Il faut également relever les messages d’erreur et les changements récents, sans demander à l’utilisateur de diagnostiquer l’infrastructure.
La priorité dépend de l’impact métier, de l’étendue de l’incident et de l’existence d’une solution de contournement. Une panne qui bloque toutes les commandes ne reçoit pas le même traitement qu’un ralentissement limité à un utilisateur.
2. Ouvrir les tickets et mobiliser les bons interlocuteurs
Le pilote crée le ticket de coordination, identifie les premières hypothèses et sollicite les supports nécessaires. Pour une panne critique dont l’origine reste incertaine, plusieurs investigations peuvent démarrer en parallèle, à condition de coordonner les changements.
Dans une activité de comptabilité et de préparation fiscale, comme celle d’Archie Contable, un portail client inaccessible peut empêcher la transmission de pièces à l’approche d’une échéance. Ce scénario illustre pourquoi le ticket doit décrire l’activité bloquée, et pas seulement indiquer « serveur indisponible ».
3. Établir un diagnostic partagé
Le diagnostic doit confronter les observations : accessibilité depuis différents sites, état des ressources hébergées, services actifs et événements récents. « Tout fonctionne chez nous » ne suffit pas à exclure un périmètre sans préciser les contrôles réalisés.
Dans le périmètre « infogérance hébergement », chaque intervenant consigne ses vérifications et leurs résultats. Des horodatages avec fuseau explicite facilitent le rapprochement des journaux, notamment lorsque les équipes se trouvent dans des territoires différents.
L’objectif est de réduire l’incertitude sans multiplier les manipulations contradictoires. Un changement doit avoir un responsable identifié et, lorsque c’est possible, une procédure de retour arrière.
4. Rétablir le service avec les validations nécessaires
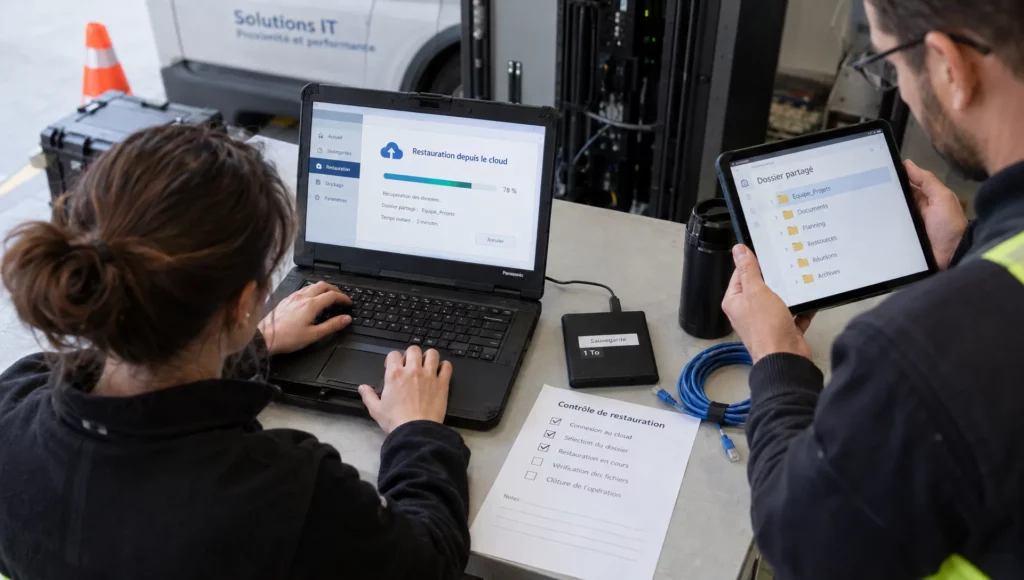
Le rétablissement peut passer par un redémarrage contrôlé, un retour arrière, une bascule ou une restauration. Le choix dépend du diagnostic, des risques et des procédures disponibles. Une solution de contournement peut permettre la reprise avant que la cause profonde soit entièrement comprise.
En cas de suspicion de cyberattaque, les mesures de confinement doivent être coordonnées avec le responsable sécurité. Il faut préserver les éléments utiles à l’investigation et vérifier les conditions d’une remise en service sûre.
La reprise technique doit ensuite être confirmée par un test métier : connexion, accès aux données et réalisation d’une opération représentative.
5. Clôturer après validation et retour d’expérience
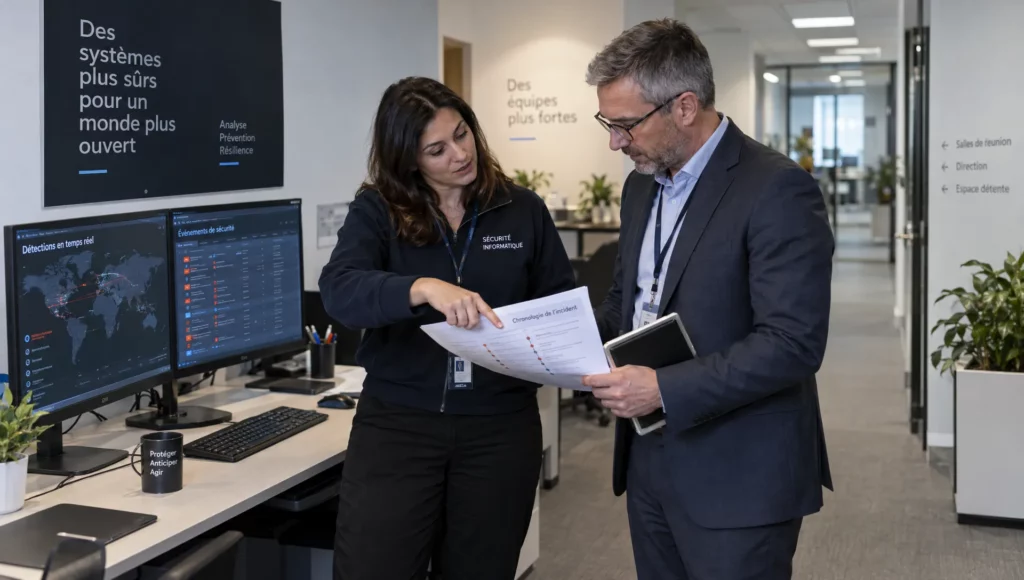
La disparition d’une alerte ne suffit pas à clôturer un incident. Le pilote vérifie la stabilité du service, fait confirmer la reprise par l’interlocuteur métier et rassemble la chronologie des actions.
Pour un incident majeur, le compte rendu doit distinguer la cause confirmée, les facteurs contributifs et les points encore incertains. Les actions correctives reçoivent un responsable et une échéance : ajustement d’alerte, correction de configuration, modification d’architecture ou amélioration de procédure.
Cette démarche permet de réduire les récidives. Elle fournit aussi une base factuelle pour discuter des engagements contractuels, sans transformer la phase de rétablissement en recherche prématurée d’un responsable.
Adapter la coordination aux contraintes des Antilles-Guyane
Pour une organisation en Martinique, Guadeloupe ou Guyane, une indisponibilité peut provenir de l’accès local alors que l’environnement hébergé reste opérationnel. Tester le service depuis un autre site ou un autre accès aide à distinguer une panne d’hébergement d’un problème de connectivité.
Le plan d’escalade doit intégrer les horaires réels des supports, les possibilités d’intervention sur site et les dépendances aux opérateurs. Un annuaire de crise accessible hors du système principal reste utile si la messagerie ou l’outil de tickets devient indisponible.
La proximité, dans une offre « infogérance hébergement », se mesure par des moyens concrets : interlocuteurs identifiés, connaissance des sites et modalités d’intervention définies. Elle ne remplace ni une architecture résiliente ni des sauvegardes testées.
Pour une organisation répartie sur plusieurs implantations, piloter l’infogérance d’un système d’information multisite suppose également de distinguer l’incident local de l’incident commun à tous les sites. Cette distinction évite de mobiliser les mauvais intervenants et permet de prioriser les activités les plus touchées.
Que demander avant de signer ou renouveler les contrats ?
Demandez aux prestataires de travailler sur un scénario commun : l’application métier est inaccessible, mais l’origine de la panne n’est pas connue. Leur réponse doit préciser qui reçoit le signalement, qui ouvre les tickets externes et qui informe la direction.
Exigez des documents utilisables pendant l’incident : matrice de responsabilités, annuaire d’escalade, procédures de reprise et inventaire des dépendances. Vérifiez également la propriété des comptes de support et les modalités de transfert si un prestataire change.
Comparer deux offres « infogérance hébergement » exige donc de regarder au-delà du prix mensuel. Un périmètre apparemment économique peut laisser à l’entreprise la coordination des fournisseurs, les restaurations ou le support applicatif.
Un exercice sur table permet de tester le dispositif sans provoquer de panne. Les intervenants déroulent le scénario et identifient les blocages : contact manquant, accès insuffisant, validation métier absente ou couverture horaire incompatible. Les écarts détectés peuvent alors être corrigés avant une interruption réelle.
FAQ : responsabilités et gestion des incidents
L’infogérant est-il responsable de toutes les pannes ? Non. Il intervient dans le périmètre prévu au contrat. Il peut coordonner une panne d’hébergement ou solliciter un éditeur sans être responsable de leur infrastructure ou de leur logiciel.
L’hébergeur doit-il réparer l’application métier ? Seulement si cette prestation fait partie de son engagement. Fournir une infrastructure ne signifie pas automatiquement administrer le système d’exploitation ou assurer la maintenance de l’application.
Qui appeler si l’origine de la panne est inconnue ? Appelez le guichet unique ou le pilote désigné. Dans un dispositif « infogérance hébergement », son rôle est d’organiser le diagnostic et l’escalade, sans exiger que l’entreprise identifie d’abord le composant défaillant.
Faut-il réunir hébergement et infogérance chez un seul prestataire ? Cela peut simplifier la coordination, mais ne dispense pas de préciser les responsabilités et les engagements. Avec deux prestataires, une organisation efficace reste possible si le pilotage et les droits d’accès sont clairement établis.
Qui valide la fin de l’incident ? Les équipes techniques confirment le rétablissement, puis un interlocuteur métier vérifie que les opérations essentielles fonctionnent. Le pilote clôture ensuite le ticket selon la procédure convenue et programme le retour d’expérience si nécessaire.
Faire évaluer votre organisation de support avec AITEC
AITEC accompagne les entreprises et collectivités des Antilles-Guyane en audit, conseil, infogérance, cloud, cybersécurité et support. Ces expertises permettent d’aborder les incidents à l’échelle du système d’information, plutôt que fournisseur par fournisseur.
Pour préparer un échange utile, rassemblez vos contrats, vos services critiques et quelques incidents récents. Vous pourrez identifier les responsabilités non attribuées, les dépendances de support et les procédures à tester. Échangez avec AITEC sur votre infrastructure et votre organisation de support afin de cadrer les points à auditer et de définir un pilotage adapté à vos besoins de continuité.